Zum Hauptinhalt springen
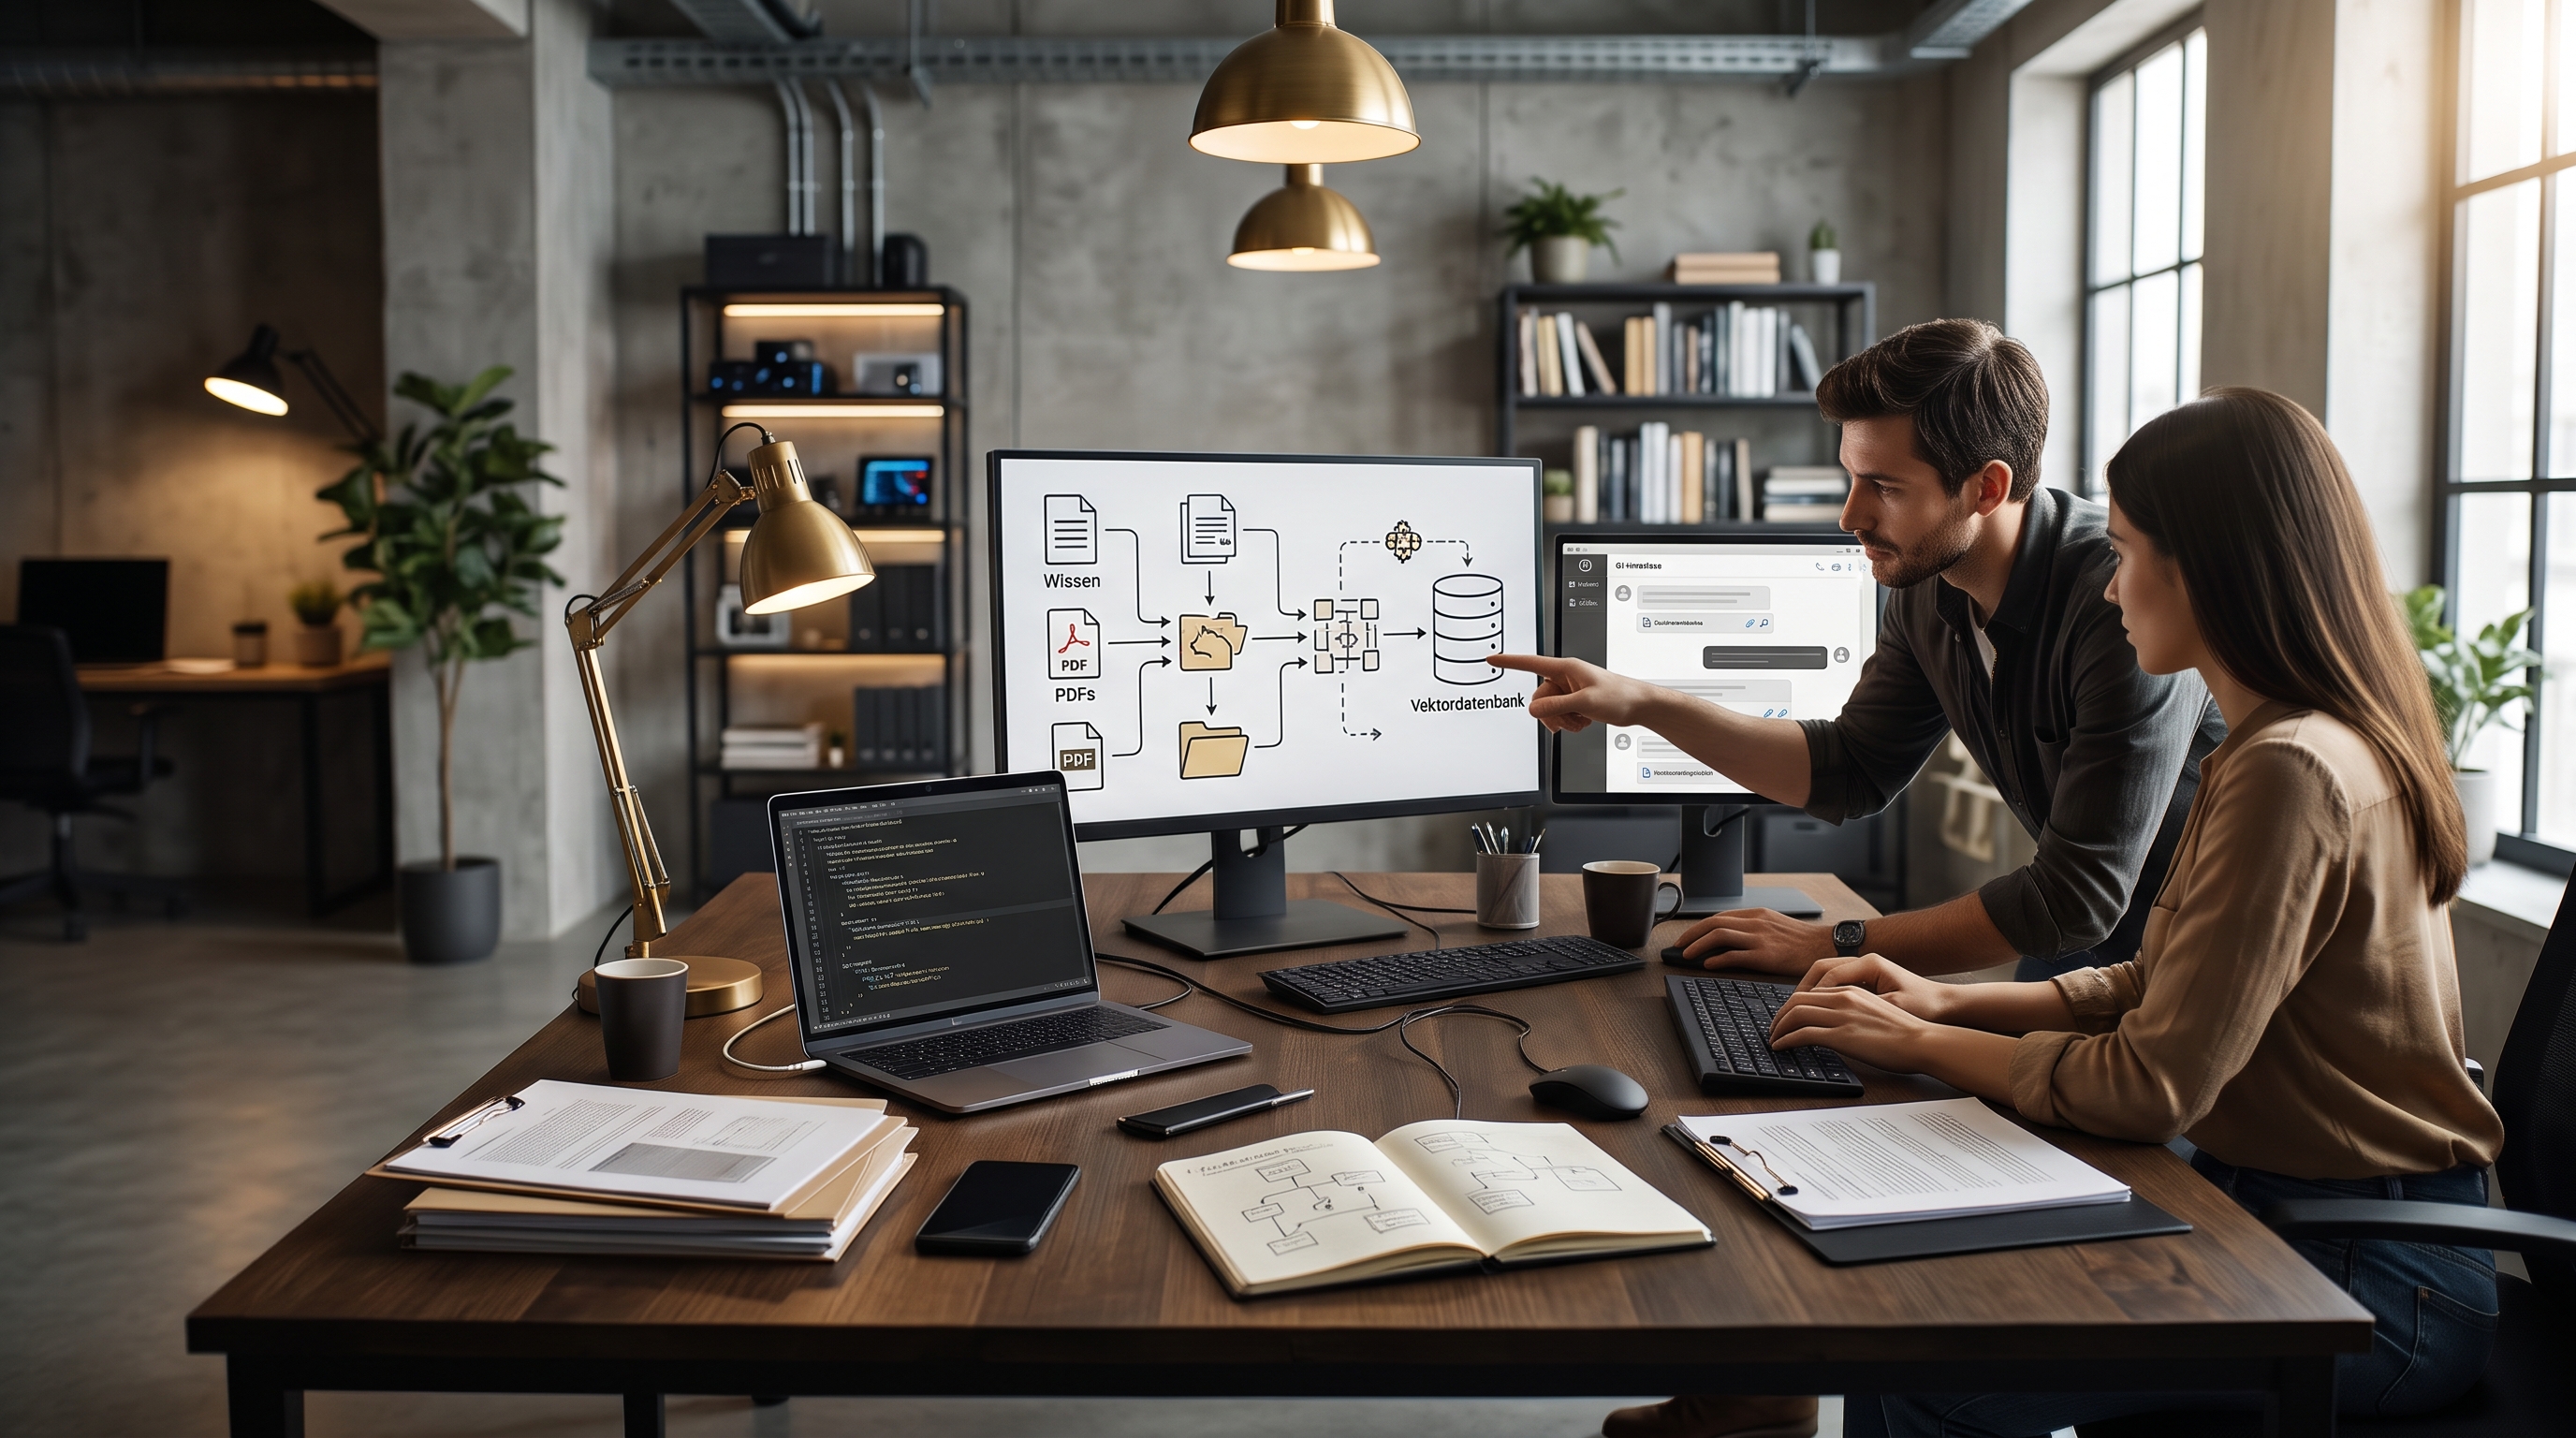
Eine Frau sitzt am Schreibtisch und tippt auf einer Tastatur, daneben ein Notebook, auf dem man Code sieht. Ein Mann steht daneben und zeigt auf einen Bildschirm, der zeigt wie Dateien aus verschiedenen Ordnern in eine gemeinsame Wissensdatenbank einfließen und gebündelt werden. Daneben ein Bildschirm, der einen KI-Chat zeigt.

Bild KI generiert

RAG
(Retrieval-Augmented Generation)

KI, die erst in deinem Wissen nachschlägt und dann antwortet. Einfach erklärt.

Kurzbeschreibung

RAG in einem Satz

RAG (Retrieval-Augmented Generation) ist ein Verfahren, bei dem ein KI-Sprachmodell vor jeder Antwort passende Informationen aus einer festgelegten Wissensquelle abruft, etwa aus deinen Handbüchern, Verträgen oder Produktdaten, und seine Antwort auf genau diese Inhalte stützt.

Der Begriff, Wort für Wort

  • Retrieval (Abruf): Das System sucht die Inhalte heraus, die zur Frage passen.
  • Augmented (angereichert): Diese Inhalte werden der Frage als Kontext beigefügt.
  • Generation (Erzeugung): Das Sprachmodell formuliert daraus eine Antwort in natürlicher Sprache.

Detail-Erklärung

Was RAG im Detail bedeutet

Ein Sprachmodell wie etwa ChatGPT hat beim Training viel über die Welt gelernt, aber nichts über dein Unternehmen. Es kennt deine Preisliste nicht, deine Wartungsanleitungen nicht und auch nicht die Vereinbarung, die ihr letzte Woche mit einem Kunden getroffen habt.

Fragst du das Sprachmodell trotzdem danach, rät es im Zweifel. Heraus kommt dann eine überzeugend formulierte, aber falsche Antwort – bzw. eine Antwort, die nicht auf dein Unternehmen passt. Fachleute nennen das Halluzination.

RAG schließt genau diese Lücke. Das Modell bekommt zu jeder Frage die passenden Textstellen aus deinen Quellen mitgeliefert und antwortet auf dieser Grundlage.

So funktioniert RAG

Hinter RAG stecken eine einmalige Vorbereitung und drei Schritte, die bei jeder Frage in wenigen Sekunden ablaufen:

  1. Vorbereitung (Wissen aufbereiten): Deine Dokumente werden in kurze Abschnitte zerlegt (Chunking). Jeder Abschnitt wird in eine Zahlenfolge übersetzt, die seine Bedeutung abbildet (Embedding) und in einer Vektordatenbank gespeichert. Das passiert einmal und danach automatisch bei jeder Änderung.
  2. Suchen (Retrieval): Auch deine Frage wird in eine solche Zahlenfolge übersetzt. Das System findet die Abschnitte mit der ähnlichsten Bedeutung, selbst wenn dort ganz andere Wörter stehen.
  3. Anreichern (Augmentation): Die gefundenen Abschnitte gehen zusammen mit deiner Frage an das Sprachmodell, verbunden mit der Anweisung, sich auf diese Inhalte zu stützen.
  4. Antworten (Generation): Das Modell formuliert eine verständliche Antwort und zeigt, aus welchen Dokumenten sie stammt.

Ein Sprachmodell ohne RAG schreibt die Prüfung aus dem Gedächtnis: Es weiß viel, verwechselt aber Details und gibt Wissenslücken ungern zu. Mit RAG darf es ins "Buch" schauen. In das "Buch", das du ihm hinlegst und das deine Unternehmensdaten beinhaltet. Die Antworten werden dadurch präziser, aktueller und überprüfbar.

Beispiel für RAG

Eine Mitarbeiterin im Kundenservice eines Maschinenbauers fragt das Sprachmodell:

"Welche Garantie gilt für Baureihe X, wenn sie im Zweischichtbetrieb läuft?"

Ohne RAG liefert die KI eine allgemeine Antwort über Garantien. Im schlechtesten Fall erfindet sie Fristen, die es so nie gab.

Mit RAG findet das System den passenden Abschnitt in den Garantiebedingungen und im Datenblatt der Baureihe. Die Antwort ist konkret und nennt beide Dokumente als Quelle. Die Mitarbeiterin kann sie mit einem Klick prüfen.

RAG, Fine-Tuning oder Datei-Upload: Was ist der Unterschied?

RAG wird oft mit anderen Wegen verwechselt, einer KI eigenes Wissen mitzugeben.

  • Datei in den Chat laden

    Funktioniert für einzelne Dokumente. Bei hunderten oder tausenden Dateien ist aber Schluss, weil nur eine begrenzte Textmenge ins sogenannte Kontextfenster passt.
  • Fine-Tuning

    Das Modell wird mit eigenen Daten nachtrainiert. Gut geeignet, um Stil, Tonalität oder ein festes Ausgabeformat beizubringen. Für Fakten weniger gut geeignet, denn das Wissen ist zum Trainingszeitpunkt eingefroren, Quellen lassen sich nicht anzeigen und einzelne Informationen lassen sich kaum wieder entfernen.

  • RAG

    Das Wissen bleibt in deinen Dokumenten. Änderungen sind sofort verfügbar, jede Antwort kann ihre Quelle nennen und gelöschte Dokumente verschwinden auch aus dem Wissen der KI.

Stärken & Grenzen

Was RAG leisten kann und wo die Grenzen liegen

Das kann RAG:

  • Antworten auf Basis deines aktuellen Wissens statt alter Trainingsdaten.
  • Nachvollziehbare Antworten dank Quellenangaben.
  • Deutlich weniger Halluzination.
  • Wissen ergänzen oder löschen, ohne das Modell neu zu trainieren.
  • Zugriffsrechte berücksichtigen: Jede Person bekommt nur Antworten aus Dokumenten, die sie auch sehen darf.

Hier liegen die Grenzen:

  • Die Antwort ist nur so gut, wie die Quellen. Veraltete oder widersprüchliche Dokumente führen zu schlechten Antworten.
  • Findet die Suche die falsche Textstelle, antwortet das Modell auf falscher Grundlage.
  • Halluzinationen werden seltener, aber nicht unmöglich.
  • RAG greift auf interne, oft auch personenbezogene Daten zu. Datenschutz nach DSGVO, Berechtigungen und IT-Sicherheit gehörten deshalb von Anfang an mit dazu.

Mini-Glossar: Begriffe rund um RAG

  • LLM (Large Language Model): Das Sprachmodell, dass die Antwort formuliert, zum Beispiel GPT, Claude, Llama.
  • Embedding: Eine Zahlenfolge, die die Bedeutung eines Textes abbildet und Texte so vergleichbar macht.
  • Vektordatenbank: Speichert Embeddings und findet blitzschnell Inhalte mit ähnlicher Bedeutung.
  • Chunking: Das Zerlegen von Dokumenten in sinnvolle Abschnitte.
  • Kontextfenster: Die Textmenge, die eine Sprachmodell auf einmal verarbeiten kann.
  • Halluzination: Eine plausibel klingende, aber falsche Antwort der KI.
  • Agentic RAG: RAG mit KI-Agente, die selbst entscheiden, wo und wie oft sie nachschlagen.